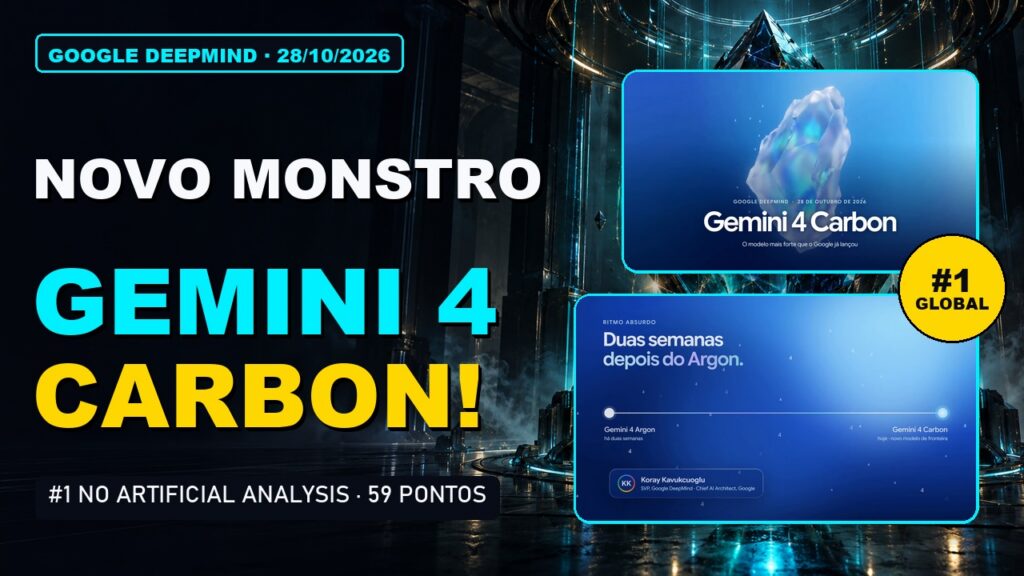
Apenas duas semanas após colocar no ar o Gemini 4 Argon, o Google DeepMind surpreendeu a comunidade global de tecnologia ao anunciar o Gemini 4 Carbon, o modelo de fronteira mais poderoso, denso e avançado já desenvolvido pela gigante de Mountain View.
O anúncio oficial, conduzido por Koray Kavukcuoglu (SVP da Google DeepMind e Chief AI Architect do Google), marcou a chegada direta do modelo ao topo do respeitado Artificial Analysis Intelligence Index v5, cravando 59 pontos e superando concorrentes históricos como o Claude Opus 5.5 e as principais variantes da OpenAI.
1. O #1 Global na Artificial Analysis
O Gemini 4 Carbon liderou 4 das 9 avaliações nucleares do índice, com destaque para raciocínio complexo, síntese científica avançada e automação de código:
- HLE-Diamond (Humanity’s Last Exam): Liderança absoluta em problemas científicos e matemáticos de fronteira.
- Terminal-Bench-Science: Resolução de ambientes de terminal com zero taxa de trapaça.
- AA-Omniscience: Precisão factual e cobertura de conhecimento enciclopédico.
- AutomationBench-AA: Execução coordenada de tarefas complexas de múltiplos passos.
2. Raciocínio Contínuo: Feito para Agentes que Operam por Dias
Um dos pontos mais ressaltados pelo Google DeepMind é a capacidade de persistência de contexto em fluxos de trabalho longos. Ao contrário dos modelos convencionais que sofrem degradação de instrução após alguns minutos de execução autônoma, o Carbon foi otimizado para operar por dias seguidos no mesmo repositório ou base de código:
- Dia 1: Mapeamento integral e análise estrutural do codebase.
- Dia 2: Isolamento e reprodução precisa de falhas e bugs complexos.
- Dia 3: Construção de patches, refatoração e execução da suíte de testes unitários.
No benchmark WebDev Arena, o Carbon registrou um salto expressivo de +89 pontos de Elo, alcançando 1.768 pontos e consolidando-se no top tier de desenvolvimento full-stack.
3. Cibersegurança no Estado da Arte
O foco em confiabilidade e defesa cibernética colocou o Gemini 4 Carbon em patamares inéditos de auditoria de software:
- SEC-bench Pro (Descoberta de falhas): 88,2% de assertividade.
- ExploitsGym (Avaliação de vulnerabilidades): 54,8%.
- CWE-bench (Correção de código vulnerável): Mais de 70% de sucesso.
De acordo com dados oficiais, o modelo entrega 2x mais código seguro em comparação direta ao Argon e até 10x mais qualidade em patches contra vulnerabilidades críticas do que modelos concorrentes do setor, assumindo a liderança em testes de intrusão web.
4. Alinhamento, Confiabilidade e Preço Agressivo
No quesito segurança de modelo, o Carbon obteve 0% de sucesso em ataques de prompt injection e reduziu em 80% os alertas graves de desalinhamento em relação a gerações anteriores.
Comercialmente, o Google optou por uma estratégia de alta pressão no mercado: manteve o preço padrão alinhado ao Argon, cobrando $2,00 por 1 milhão de tokens de entrada e $10,00 por 1 milhão de tokens de saída, com suporte a uma gigantesca janela de 1 Milhão de tokens de contexto e desconto de até 95% em prompt caching.
5. As Ressalvas Honestadas: Onde Ele Não Vence
Apesar de liderar o índice geral consolidado, o Google fez questão de pontuar que a disputa segue aberta em frentes especializadas:
- Engenharia de Software de Fronteira: O GPT-6 Astra (OpenAI) mantém a primeira colocação no FrontierSWE 2.
- Uso de Sistema Operacional (Computer Use): O Claude Opus 5.5 (Anthropic) segue na liderança no OSWorld 2.1.
Disponibilidade
O lançamento ocorre de forma gradual: pesquisadores de segurança cibernética e parceiros governamentais já têm acesso a partir desta semana, com liberação empresarial e pública prevista para as próximas semanas através do Google AI Studio, Vertex AI e Gemini Advanced.